[Lap 02] 테스트 300개와 Claude 토큰 소진: TDD 엄격성의 명암
순수 바이브 코딩으로 짰던 증권사 자동매매 봇은 실전에서 언제 터질지 모르는 시한폭탄이었습니다.
위기감 속에서superpowers14종 스킬을 도입해 301개의 빈틈없는 단위 테스트와 단단한 엔진을 얻었지만, 곧이어 사소한 코드 한 줄 수정에도 수만 토큰이 녹아내리는 극심한 Token Burn과 마주했습니다. 1인 개발자로서 겪었던 완벽주의의 함정과 실용적 모델 티어링으로의 진화 과정을 기록합니다.
1. 프롤로그: ‘바이브 코딩(Vibe Coding)’의 달콤함과 식은땀 흘린 민낯
Lap 01에서 라오어 무한매수법의 구조적 한계를 짚고, 27년간 282번 작동했던 ‘RSI(10) < 30 급락 후 익일 반등 통계(t=4.3, +63bp)’를 확인했을 때만 해도 모든 것이 순조롭게 풀릴 것 같았습니다. 통계적 팩트가 분명했으니, 이제 남은 일은 이 로직을 증권사 API와 연동해 매일 아침 자동으로 주문을 넣어주는 파이썬 스크립트를 작성하는 것뿐이었습니다.
당시 저는 여느 개발자들처럼 최신 LLM의 놀라운 코드 생성 능력에 흠뻑 빠져 있었습니다.
그 시절에는 리서치 전담 에이전트나 검증 에이전트 같은 정교한 분업 체계도 없었고, 뒤에서 소개할 superpowers 같은 방법론 스킬도 전혀 알지 못했습니다. 오직 대화창에 단일 Claude 모델 하나를 띄워두고 감각에 의존해 대화를 주고받는, 이른바 ‘순수 바이브 코딩(Pure Vibe Coding)’에 전적으로 기대어 작업을 진행했습니다.
"한국투자증권(KIS) 해외주식 Open API 연동해서 매일 아침 미국장 시작할 때
전일 종가 RSI(10) 계산하고, 30 미만이면 TQQQ 시장가 매수 주문 넣는 파이썬 코드 짜줘.
에러 안 나게 깔끔하게 작성해 줘."
엔터를 누르면 불과 3초 만에 200줄에 달하는 파이썬 코드가 물 흐르듯 화면을 채웠습니다. 토큰 발급 함수부터 시세 조회, 주문 전송까지 겉보기에는 군더더기 하나 없는 완벽한 프로그램처럼 보였습니다. 사소한 문법 에러가 나면 에러 메시지를 복사해 다시 창에 던졌고, AI는 곧바로 “죄송합니다, 수정했습니다”라며 고쳐진 코드를 내놓았습니다.
마치 마법이라도 부리는 듯한 기분이었습니다.
하지만 모의투자 계좌를 연결하고 프로그램을 실제로 구동한 지 불과 며칠 만에, 저는 등줄기에 식은땀이 흐르는 것을 느끼며 프로세스를 황급히 강제 종료해야 했습니다.
화면 뒤편에서 벌어지고 있던 현실은 말 그대로 아수라장이었습니다:
- OAuth2 토큰 만료 크래시 (
401 Unauthorized): 증권사 토큰 유효 기간은 24시간인데, 코드는 처음에 발급받은 토큰 하나를 영원히 재사용하려다 하루 만에 조용히 뻗어 있었습니다. - Fire-and-Forget 접수 오인: API 서버의 접수 완료(
rt_cd: 0) 응답만 보고 주문이 전량 체결되었다고 착각하여 가상 장부를 멋대로 갱신했습니다. - 휴장일 결측치 크래시 (
IndexError): 미국 현지 공휴일로 빈 배열([])이 들어오자df['close'].iloc[-1]에서 즉시 프로세스가 사망했습니다. - 타임아웃 없는 무한 프리징: 장 초반 증권사 트래픽 폭주로 응답이 지연되자
timeout파라미터가 없는 HTTP 소켓을 물고 영원히 멈춰 섰습니다.
일반적인 토이 프로젝트나 사내 웹 서비스라면 배포 후 500 에러를 보고 다음 날 느긋하게 패치하면 그만일지 모릅니다.
하지만 실전 트레이딩 시스템은 다릅니다. 네트워크 프리징 한 번, 예외 처리 누락 한 번이 곧바로 실제 계좌의 회복 불가능한 자본 손실(Capital Loss)로 이어집니다.
감각과 요행에 기댄 바이브 코딩으로 빚어낸 봇은 자동매매 프로그램이 아니라, 언제 내 자산을 집어삼킬지 모르는 시한폭탄에 불과했습니다.
2. 구원투수의 등장: superpowers 14종 스킬을 프로젝트에 벤더링하다
“AI에게 자유롭게 코딩할 권한을 주면 안 된다. 실패를 기본 전제로 깔고 들어가는 엄격한 엔지니어링 규율이 반드시 필요하다.”
이 뼈저린 위기감 속에서 찾은 해법이 바로 오픈소스 방법론 스킬 모음인 superpowers (v6.3.0)였습니다.
superpowers는 에이전트가 곧바로 코드를 타이핑하지 못하도록 손발을 묶고, 엔터프라이즈 소프트웨어 공학의 정석인 [요구사항 정의 ➔ 아키텍처 스펙 ➔ 작업 플랜 분할 ➔ 테스트 주도 개발(TDD) ➔ 터미널 검증]을 강제하는 14종의 방법론 스킬 체계입니다.
저는 곧바로 실전 자동매매 시스템인 dipx 프로젝트의 .claude/skills/ 디렉터리에 superpowers 14종 스킬을 프로젝트 스킬 형태로 직접 벤더링했습니다:
dipx/
  .claude/skills/                  # superpowers 14개 스킬 벤더링
    ├── brainstorming/             # 구현 전 요구사항 인터뷰 및 설계 게이트
    ├── writing-plans/             # 2~5분 단위 바이트 플랜 작성
    ├── test-driven-development/   # RED-GREEN-REFACTOR TDD 엔진
    ├── verification-before-completion/ # 실행 증거 필수 확인
    ├── systematic-debugging/      # 4단계 근본 원인 추적 디버거
    └── subagent-driven-development/ # 독립 서브에이전트 작업 실행
  CLAUDE.md                        # 프로젝트 절대 규칙 및 git 없는 환경 오버라이드
규칙은 단순하고도 서슬 퍼랬습니다.
“사용자의 명시적 승인 없이 에이전트는 단 한 줄의 구현 코드도 먼저 쓸 수 없다.”
자유방임적이던 바이브 코딩의 시대가 끝나고, 혹독한 엔지니어링 규율의 시대가 열린 것입니다.
3. 슈퍼파워즈의 혹독한 규율: 스펙, 플랜, 그리고 TDD의 3중 게이트
superpowers를 설치한 뒤 에이전트의 행동은 180도 달라졌습니다.
예를 들어 “SOXX 신호에 변동성 손절 규칙을 추가해줘”라고 입력하면, 예전처럼 코드를 와르르 쏟아내는 대신 차분하게 질문을 던져왔습니다:
Using brainstorming to clarify requirements...
"변동성 손절(Stop-loss)을 적용할 때, 전일 종가 기준 ATR(14)의 몇 배수를 임계값으로
잡으실 건가요? 2배수와 3배수 중 어떤 시뮬레이션을 기준으로 하시겠습니까?"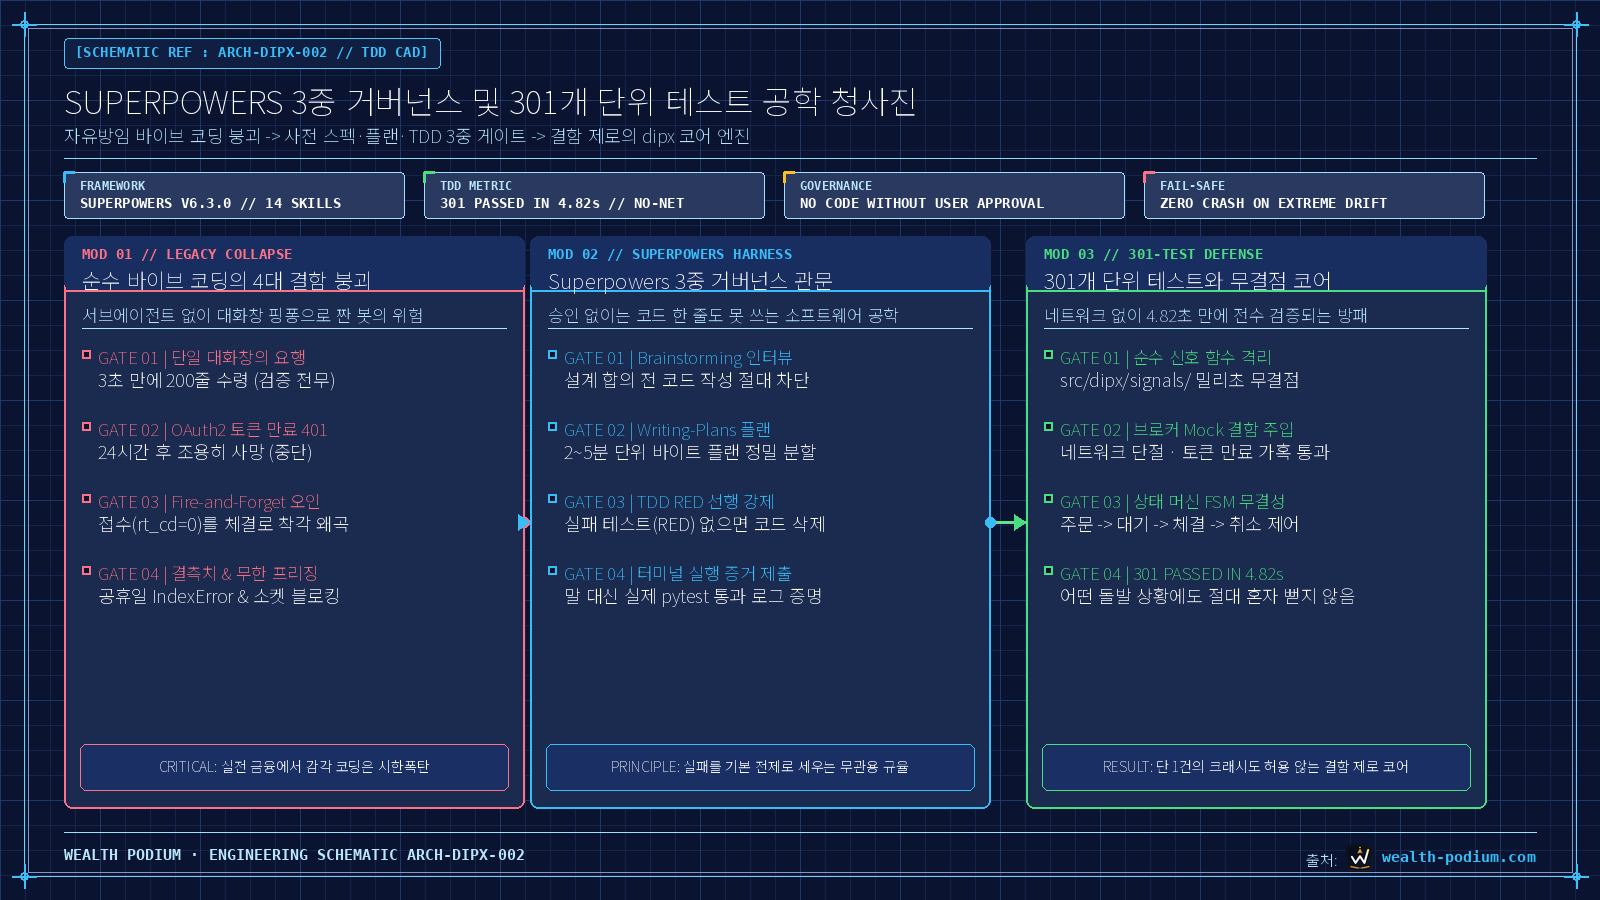
도식 원본 보기
flowchart TD
    subgraph S1["1단계: 요구사항 브레인스토밍 (brainstorming)"]
        A1["기능 요구 또는 버그 제기"] --> A2["질문을 한 번에 하나씩 던짐<br/>(의도 명확화 전 코드 작성 절대 금지)"]
        A2 --> A3["사용자 승인 게이트 1 (설계 합의)"]
    end

    subgraph S2["2단계: 스펙 & 바이트 플랜 (writing-plans)"]
        A3 --> B1["설계 스펙 작성<br/>(docs/superpowers/specs/)"]
        B1 --> B2["2~5분 단위 작업 플랜 분할<br/>(대상 파일, 코드 스펙, 검증 명령 명시)"]
        B2 --> B3["사용자 승인 게이트 2 (플랜 합의)"]
    end

    subgraph S3["3단계: 무관용 TDD 루프 (test-driven-development)"]
        B3 --> C1["RED: 실패하는 단위 테스트 먼저 작성"]
        C1 --> C2["pytest 실행하여 실패(RED) 눈으로 확인"]
        C2 --> C3["GREEN: 테스트를 통과하는 최소한의 코드 작성"]
        C3 --> C4["pytest 통과(GREEN) 확인 및 리팩터링"]
    end

    subgraph S4["4단계: 종결 증명 (verification-before-completion)"]
        C4 --> D1["실제 터미널 실행 출력 제출<br/>('완료되었습니다' 말 대신 pytest 301 passed 증거 제시)"]
    end

    S1 --> S2 --> S3 --> S4
이 워크플로우의 핵심은 ‘3중 게이트’에 있었습니다:
brainstorming게이트:- 작업을 스파이크(Spike), 제한적 수정(Bounded), 아키텍처(Architectural)로 자동 분류합니다.
- 질문을 한 번에 하나씩만 던지며, 설계가 완벽히 합의되기 전에는 어떠한 코드 제안도 엄격히 차단했습니다.
writing-plans게이트:- 승인된 설계를 바탕으로
docs/superpowers/plans/에 2~5분 단위로 쪼갠 초소형 태스크 목록을 생성합니다. - 어느 파일의 몇 번째 줄을 수정할지, 어떤 테스트 함수를 추가할지 사전에 정밀하게 정의했습니다.
test-driven-development게이트 (RED-GREEN-REFACTOR):- RED: 구현할 기능에 대한 실패하는 테스트를 먼저 작성하고 터미널에서 실제로 실패하는지 확인합니다.
- 만약 테스트를 작성하기 전에 구현 코드를 한 줄이라도 먼저 쓰면, 스킬 규칙에 따라 작성한 코드를 강제로 지우고 다시 테스트부터 쓰도록 조치되었습니다.
- GREEN: 테스트를 통과하기 위한 가장 최소한의 코드만 작성하고 통과를 확인합니다.
verification-before-completion:- “작업이 성공적으로 끝났습니다”라는 식의 주관적인 선언을 금지하고, 실제
pytest의 녹색 통과 로그를 터미널 출력으로 직접 제시해야만 태스크를 완료할 수 있었습니다.
4. 빛: 301개의 테스트와 절대 뻗지 않는 dipx 코어 엔진
이 가혹할 정도로 엄격한 프로세스를 밀어붙이자, 마법 같은 변화가 일어났습니다.
가장 먼저 네트워크에 의존하던 지저분한 API 연동 코드에서 순수 신호 계산 로직(src/dipx/signals/)을 완벽하게 분리해 냈습니다. 외부 환경에 영향을 받지 않는 순수 함수(Pure Function)로 구성되었기 때문에 수백 번을 돌려도 1초 만에 테스트가 끝났습니다.
증권사 API를 호출하는 브로커 어댑터(app/broker/) 역시 가짜 객체(Mock)를 통해 가혹한 결함 주입(Fault Injection) 테스트를 거쳤습니다:
- 네트워크 연결이 10초간 끊어졌을 때의 지수 백오프 재시도 검증
- 토큰 만료 5분 전 자동 갱신 및
401 Unauthorized수신 시 투명한 즉시 재발급 검증 - 미국 공휴일 조기 폐장 및 비정상 데이터 유입 시 안전 기본값(Fail-Safe) 복귀 검증
- 매수 주문 후 미체결 수량이 남았을 때의 정정/취소 상태 머신 검증
(.venv) PS D:claude-projectsdipx> python -m pytest tests -q
........................................................................................ [ 29%]
........................................................................................ [ 58%]
........................................................................................ [ 87%]
......................................                                                   [100%]
301 passed in 4.82s
터미널에 찍힌 301 passed in 4.82s.
네트워크 접근 없이 단 4.8초 만에 301개의 방패가 일제히 초록불을 켜며 시스템의 건전성을 증명해 보였습니다.
어떠한 돌발 악재나 이상 데이터가 들어와도 프로그램이 혼자 조용히 크래시를 일으키며 뻗는 일은 더 이상 없었습니다. 과거 바이브 코딩 시절 느꼈던 서늘한 불안감은 사라지고, 시스템을 온전히 장악했다는 짜릿한 기술적 희열이 밀려왔습니다.
5. 그림자: 사소한 한 줄에 수십만 토큰이 녹아내리던 밤 (Token Burn)
하지만 기쁨도 잠시, 시스템이 완벽해질수록 전혀 예상치 못했던 또 다른 현실적인 장벽이 저를 덮쳤습니다.
바로 상상을 초월하는 토큰 소모(Token Burn)와 API 청구서 폭탄이었습니다.
순수 바이브 코딩 시절에는 질문 하나를 던지고 코드를 받아오는 데 수백~수천 토큰이면 충분했습니다. 하지만 superpowers를 장착한 이후로는 상황이 완전히 달라졌습니다.
예를 들어 장 마감 후 슬랙(Slack)으로 발송되는 알림 메시지의 이모지 하나를 바꾸거나, RSI 진입 임계값을 30에서 28로 2포인트 내리는 아주 사소한 수정을 하려 해도 시스템은 타협 없이 정규 프로세스를 밟았습니다:
도식 원본 보기
flowchart LR
    subgraph Trap["단일 모델 + 거대 스펙 환경의 컨텍스트 팽창 폭탄"]
        T1["'슬랙 이모지 하나 바꿔줘'"] --> T2["brainstorming 발동<br/>(장문의 인터뷰 질문 3개 출력)"]
        T2 --> T3["writing-plans 발동<br/>(수백 줄의 설계 스펙 & 플랜 문서 생성)"]
        T3 --> T4["컨텍스트 폭발<br/>(301개 테스트 파일 + 스펙 + 히스토리 로드)"]
        T4 --> T5["Token Burn 재앙<br/>(사소한 수정 1번에 10만~15만 토큰 증발)"]
    end
brainstorming의 과도한 진지함: 사소한 문구 수정임에도 불구하고 에이전트는 “이 변경이 다른 알림 채널에 미치는 영향은 무엇입니까?”, “메시지 포맷의 하위 호환성을 어떻게 검증할까요?”라며 꼬치꼬치 질문을 던져왔습니다.- 거대한 스펙과 플랜 파일의 누적: 스펙 문서와 플랜 문서를 마크다운으로 꼼꼼하게 작성하다 보니, 대화 한 번에 수천 줄의 텍스트가 컨텍스트 창에 고스란히 쌓였습니다.
- 301개 테스트 코드의 컨텍스트 압박: TDD를 위해 테스트 파일 전체를 읽고 검증 출력을 주고받는 과정에서, 매 턴마다 수만 토큰이 기본으로 소비되었습니다.
결과는 참혹했습니다.
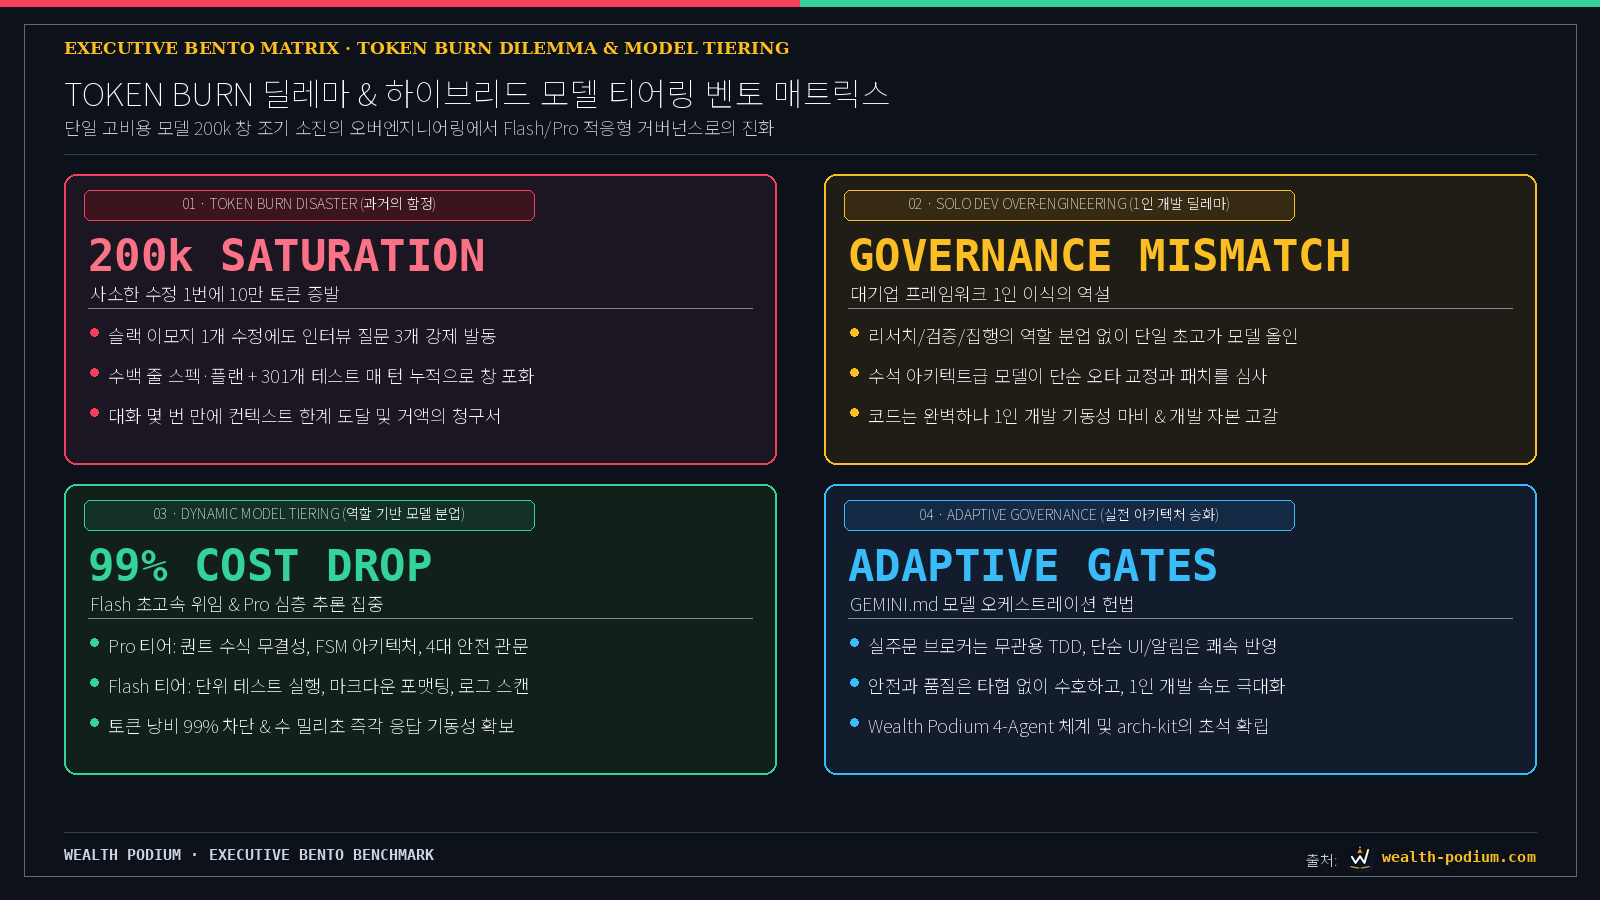
Claude의 200k 토큰 컨텍스트 창은 불과 서너 번의 질문과 답변만으로 70~80% 이상 빠르게 채워졌습니다. 대화가 조금만 길어져도 곧바로 컨텍스트 한계(Context Exhaustion)에 도달해 세션이 강제로 압축(Compact)되거나 끊기기 일쑤였습니다.
사소한 파라미터 하나를 고치는 데 수만에서 많게는 10만 토큰 이상이 허공으로 날아갔고, 월말 계좌에 찍힌 Claude API 사용료는 취미로 개발하는 1인 엔지니어가 감당하기에 결코 가볍지 않은 금액으로 불어나 있었습니다.
6. 1인 개발자의 깊은 고뇌: 엔터프라이즈 완벽주의 vs 실용적 기동성의 딜레마
밤늦게 모니터 앞에 앉아 타들어 가는 토큰 게이지를 바라보며 깊은 자괴감과 회의가 밀려왔습니다.
“테스트 300개를 얻고, Claude 토큰을 잃었다.”
제가 도입한 superpowers는 원래 실리콘밸리의 수십, 수백 명 단위 엔지니어링 조직이나 미션 크리티컬한 대규모 프로덕션 시스템에서나 어울릴 법한 엔터프라이즈급 초중량 거버넌스 프레임워크였습니다.
그런 무거운 방법론을, 리서치 전담이나 검증 전담 서브에이전트 같은 효율적인 분업 구조도 없이, 그리고 모델 간의 체급 차이를 고려한 모델 티어링도 없이, 단 하나의 초고지능·고비용 LLM 모델(Claude Sonnet/Opus)에 통째로 얹어버린 것이 화근이었습니다.
- 오타 하나, 주석 한 줄을 고치는 단순 작업조차 최고 성능의 고비용 모델이 3중 게이트를 거치며 심사를 하고 있었던 셈입니다.
- 코드는 더할 나위 없이 단단해졌지만, 정작 1인 개발자의 기동성은 완전히 마비되었고 비용은 눈덩이처럼 불어났습니다.
“완벽주의(Over-Engineering)에 도취되어 실용성을 잃어버린 엔지니어링은 결국 스스로를 갉아먹는다.”
1인 개발자에게 필요한 것은 무조건적인 규율의 극대화가 아니라, 시스템의 안전을 지키면서도 비용과 속도를 최적화할 수 있는 ‘유연하고 지능적인 페어 프로그래밍 아키텍처’였습니다.
7. 교훈과 진화: 모델 티어링(Flash vs Pro)과 경량 하이브리드 거버넌스로
이 뼈아픈 토큰 번(Token Burn)의 시련은 저에게 매우 귀중한 아키텍처적 깨달음을 안겨주었습니다. 모든 작업에 최고 스펙의 비싼 모델을 풀파워로 쏟아붓는 것은 명백한 자원 낭비라는 사실이었습니다.
저는 점진적으로 워크플로우를 뜯어고치기 시작했습니다:
도식 원본 보기
flowchart TD
    subgraph Legacy["과거의 실수: 단일 고비용 모델 올인 (Token Burn)"]
        L1["모든 작업 요청<br/>(단순 오타 수정부터 퀀트 수학 검증까지)"] --> L2["초고비용 대형 모델 1기 단독 처리<br/>(Claude Opus / Sonnet)"]
        L2 --> L3["초경량 작업에도 200k 창 포화 & 비용 폭탄"]
    end

    subgraph Modern["현재의 진화: 역할 기반 모델 티어링 (Model Tiering)"]
        M1["작업 복잡도 및 리스크 자동 분류"] --> M2{"작업 유형 판별"}

        M2 -->|"복잡한 아키텍처 / 퀀트 시그널 / ADR"| M3["고지능 심층 모델 (Pro Tier)<br/>- 정밀한 추론 및 수학적 무결성 검증"]
        M2 -->|"단순 파일 수정 / 단위 테스트 / 로그 스캔"| M4["초고속 초경량 모델 (Flash / Flash-Lite Tier)<br/>- 99% 비용 절감 & 수 밀리초 즉각 응답"]
    end

    Legacy -.->|"아키텍처 전환"| Modern
1. 역할 기반 모델 티어링 (Model Tiering Policy)
Pro/ 고지능 모델: 수학적 엄밀성이 요구되는 퀀트 시그널 수식 검증, 유한 상태 머신(FSM) 아키텍처 설계, 보안 및 장애 복구 전략 등 깊은 사고가 필요한 구간에만 집중 투입합니다.Flash/Flash-Lite초경량 모델: 단순 파라미터 치환, 마크다운 포맷팅, 이미 작성된 pytest 구동 및 출력 확인, 로그 스캔 등 정형화된 작업은 초경량 모델에게 위임하여 비용을 99% 이상 절감합니다.
2. 가변 거버넌스 (Adaptive Governance)
- 무조건적인 6단계 스펙 강제를 벗어나, 작업의 위험도에 따라 게이트의 깊이를 유연하게 조절합니다.
- 내부 장부 회계나 실주문 브로커 수정은 엄격한 TDD를 고수하되, 단순 UI 문구나 알림 포맷 변경은 불필요한 브레인스토밍을 건너뛰고 신속하게 처리하는 유연성을 확보했습니다.
이때 흘린 식은땀과 비용 청구서의 교훈은 고스란히 축적되어, 훗날 wealth-podium.com 블로그를 지탱하는 GEMINI.md의 동적 모델 선택 정책(Dynamic Model Selection Policy)과 경량 아키텍처 키트(arch-kit)의 핵심 설계 철학으로 이어지게 되었습니다.
8. 에필로그 & 다음 Lap 예고 (Lap 03)
superpowers의 혹독한 TDD 훈련을 거치며 코드는 301개의 방패 뒤에서 절대 쓰러지지 않는 무결성을 얻었습니다.
그리고 모델 티어링을 통해 급증하던 토큰 소진 부담을 덜어내며, 1인 개발자로서 시스템을 통제할 수 있는 균형점을 찾았습니다.
이제 모든 준비가 끝났다고 믿었습니다. 모의투자 환경에서 수주일 동안 단 한 건의 에러도 없이 깔끔하게 주문이 나가고 체결되는 것을 확인했기 때문입니다.
하지만 실전 시장은 엔지니어의 오만함을 결코 너그럽게 보아넘기지 않았습니다.
코드가 결함 없이 완벽하게 돌아가는 것과, 현실의 증권사 거래소와 돈이 오가는 실전 환경은 완전히 다른 차원의 영역이었습니다.
모의투자에서 완벽했던 코드를 실계좌에 투입하자마자, 가상 장부의 잔고와 증권사 실제 계좌의 주식 수가 어긋나기 시작하는 ’10/21 실전 주문 체결 대사 장애’라는 상상도 못 했던 복병이 저를 기다리고 있었습니다.
다음 [[Track 03 – Lap 03]](/track-03-lap-03-order-reconciliation-and-fail-closed-gates/)에서는 모의투자의 함정과 실제 체결 불일치를 겪으며 탄생한 ‘4대 Fail-Closed 안전 게이트와 실시간 장부 대사 아키텍처’의 치열했던 복기 기록을 전해드리겠습니다.
본 포스트는 실전 자동매매 시스템 dipx를 개발하며 겪은 엔지니어링 시행착오와 실측 데이터를 기록한 기술 일지입니다. 특정 종목이나 투자 기법에 대한 매수/매도 추천이 아니며, 모든 투자의 최종 책임은 투자자 본인에게 있습니다.