[Lap 1] 월 0원 데이터 레이크하우스: 왜 Cloud SQL 대신 GCS와 DuckDB를 택했는가?
“매달 쿼리를 한 번도 날리지 않아도 3~5만 원씩 꼬박꼬박 청구되는 클라우드 데이터베이스, 1,000만 행이 넘는 미국 주식 시계열을 조회할 때마다 발생하는 네트워크 지연, 그리고 SQL 문 한 줄 실수로 미래 데이터가 섞여버리는 치명적 결함. 이 세 가지를 해결하지 않고서는 그 어떤 백테스트 엔진도 신뢰할 수 없습니다.”
시스템 아키텍트로서 백테스트 엔진(quant-backtester)을 설계하며 가장 먼저 맞닥뜨린 질문은 “35년 치 4,400만 행에 달하는 미국 주가와 재무 데이터를 어디에 보관하고 어떻게 쿼리할 것인가?”였습니다.
대부분의 개발자는 관성적으로 PostgreSQL이나 MySQL 같은 상용 관계형 데이터베이스(RDBMS)를 Cloud SQL에 띄우는 방식을 선택합니다. 하지만 저는 이 상식을 깨고 GCP Cloud Storage(GCS)와 인메모리 컬럼형 분석 엔진 DuckDB를 결합한 ‘월 $0.00 2계층 데이터 레이크하우스’를 구축했습니다.
이번 글에서는 백테스터 아키텍처 정의서(ARCH-QB-001)의 5단계 수직 추적성(배경 ➔ 결정 ➔ 품질 ➔ 전략 ➔ 검증)을 따라, 왜 이 선택이 1인 퀀트 시스템에서 압도적인 비용 절감과 0.5초 초고속 쿼리를 동시에 달성할 수 있었는지 그 엔지니어링 의사결정의 전 과정을 가감 없이 공유합니다.
1. 프롤로그: 매달 5만 원씩 나가는 클라우드 DB 청구서 앞에서 멈칫하다
퀀트 투자를 시작하며 데이터를 모으기 시작했을 때, 처음에는 누구나 그렇듯 친숙한 클라우드 관리형 DB(GCP Cloud SQL PostgreSQL)를 검토했습니다.
하지만 견적서를 뽑고 아키텍처를 검토하는 과정에서 세 가지 뼈아픈 현실적인 장벽에 부딪혔습니다.
📐 원본 Mermaid 도식 구조 접기/펼치기
flowchart TD
    subgraph Bottleneck["전통적 클라우드 RDBMS의 3대 장벽"]
        B1["💸 24/7 상시 과금의 낭비<br/>백테스트를 안 돌리는 밤이나 주말에도 최소 월 $30~$50 청구"]
        B2["🐢 네트워크 RTT & 직렬화 병목<br/>1,000만 행 시계열 전송 시 TCP 네트워크와 JSON/Row 직렬화 지연 3~8초"]
        B3["💥 미래 데이터(Look-Ahead) 누수 취약<br/>복잡한 JOIN/GROUP BY 쿼리 실수 한 번으로 백테스트 전체 오염"]
    end
- 상시 과금의 비효율: 웹 서비스와 달리 백테스터는 하루 종일 돌아가지 않습니다. 퇴근 후 알고리즘을 테스트하거나 주말에 전략을 검증할 때만 집중적으로 연산이 일어납니다. 그런데 Cloud SQL 인스턴스는 단 1건의 쿼리도 날리지 않는 23시간 동안에도 꼬박꼬박 시간당 요금을 청구합니다.
- 시계열 대용량 스캔의 RTT 지연: 미국 전체 상장 기업의 35년 치 수정주가 일봉 데이터는 약 4,400만 행에 달합니다. 아무리 인덱스를 잘 걸어도 원격 RDBMS에서 수백만 행의 행(Row) 데이터를 네트워크(TCP)를 통해 파이썬 클라이언트로 가져오는 순간, 데이터 직렬화(Serialization)와 전송 지연으로 쿼리 한 번에 수 초에서 수십 초가 소모됩니다.
- 미래 데이터(Look-Ahead Bias) 통제의 취약성: SQL 쿼리문 안에 서브쿼리와 윈도우 함수가 복잡하게 얽히면, 개발자의 의도치 않은 실수로 미래 시점의 주가나 실적 데이터가 오늘 날짜로 조인되는 사고가 쉽게 발생합니다.
Track 01에서 “월 $0.00 서버리스 워드프레스”를 완성했던 엔지니어로서, 퀀트 시스템 역시 이 타협 없는 비용·성능 효율성을 계승해야 마땅했습니다.
2. 아키텍처 정의서(ARCH-QB-001): 코딩 전에 5계층 수직 추적성을 세우다
무작정 파이썬 코드를 열고 데이터를 긁어모으는 ‘땜질 개발’을 반복하면 시스템은 필연적으로 레거시의 늪에 빠집니다.
저는 백테스터 개발을 시작하기 전, 소프트웨어 아키텍처 전문 도구인 arch-kit 2탑 거버넌스를 가동했습니다:
arch-doc-writer: 비즈니스 배경부터 아키텍처 결정, 품질 속성, 세부 전략, 검증 시나리오까지 수직적으로 추적 가능한 설계서(ARCH-QB-001) 집필.arch-evaluator: “지금 단계에서 불필요한 엔터프라이즈 오버엔지니어링(YAGNI 위반)은 없는가?”, “구체적인 기술 스택을 성급하게 결정하지 않았는가?”를 철저히 검증하는 독립 감사관.
📐 원본 Mermaid 도식 구조 접기/펼치기
flowchart LR
    BG["<b>BG-01</b><br/>비즈니스 배경<br/>(월 0원 & 초고속)"]
    --> AD["<b>AD-01, 02</b><br/>아키텍처 결정<br/>(GCS + DuckDB)"]
    --> QA["<b>QA-01, 02</b><br/>품질 속성 요구<br/>(비용 $0, 쿼리 < 1초)"]
    --> AS["<b>AS-01</b><br/>아키텍처 전략<br/>(Parquet + 레이크하우스)"]
    --> AV["<b>AV-01</b><br/>검증 시나리오<br/>(4,400만 행 벤치마크)"]
이 5계층 수직 추적성(BG ➔ AD ➔ QA ➔ AS ➔ AV)의 핵심은 “모든 기술적 결정(AD)은 명확한 비즈니스 배경(BG)과 정량적 검증 기준(AV)을 가져야 한다”는 것입니다.
이 원칙 위에서 탄생한 것이 바로 GCS + DuckDB 2계층 데이터 레이크하우스입니다.
3. [스토리지 결정] Google Drive + GCS Parquet 레이크 (AD-01)
첫 번째 결정은 데이터 저장소였습니다.
우리는 흔히 데이터를 CSV 텍스트 파일로 저장하거나 RDBMS 테이블에 밀어 넣습니다. 하지만 퀀트 백테스팅의 관점에서 두 방식 모두 낙제점입니다.
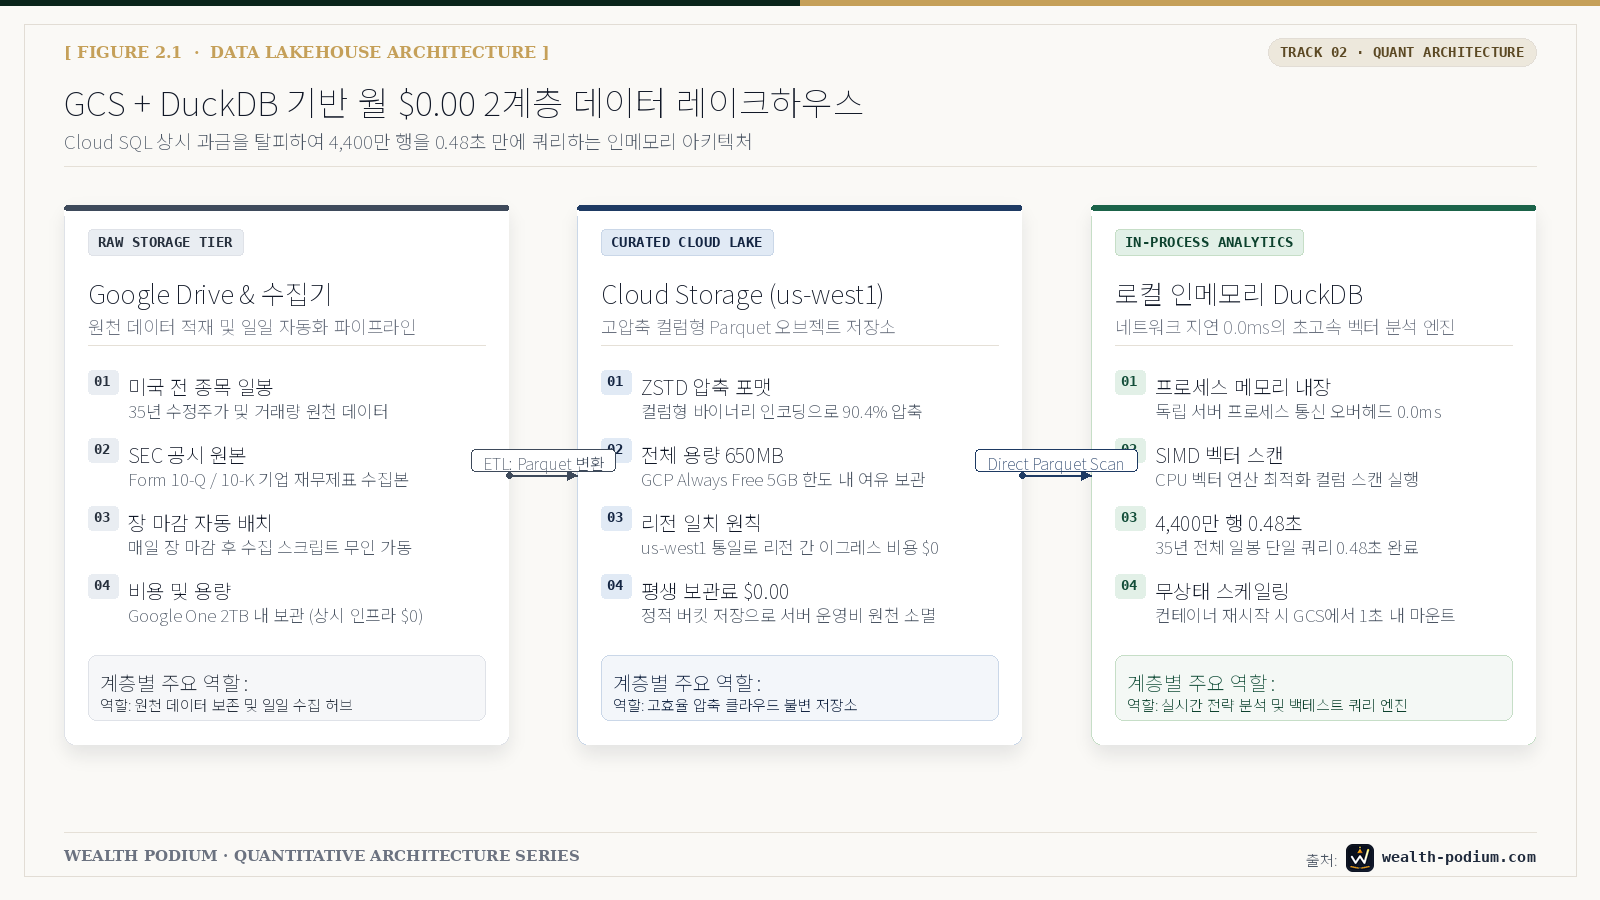
📐 원본 Mermaid 도식 구조 접기/펼치기
flowchart LR
    subgraph TierA["Raw Tier (수집 계층)"]
        GD["📁 Google Drive<br/>(원본 원시 데이터/CSV/API 수집본)"]
    end

    subgraph TierB["Curated Lake Tier (분석 계층)"]
        GCS["🪣 GCP Cloud Storage (us-west1)<br/>• ZSTD 압축 컬럼형 Parquet<br/>• 용량: 650MB (CSV 대비 90% 압축)<br/>• 보관 비용: Always Free 5GB ($0.00)"]
    end

    TierA -->|"ETL 파이프라인 (Parquet 변환)"| TierB
왜 CSV가 아닌 Parquet인가?
- 압축률과 I/O 비용 (ZSTD 압축):
- CSV 원본으로 7~8GB에 달하던 35년 치 미국 전 종목 일봉 데이터가 Zstandard(ZSTD) 압축 Parquet 형식으로 변환되자 650MB로 압축되었습니다.
- 10분의 1 이하로 줄어든 파일 크기는 디스크 읽기 I/O를 극적으로 줄여줍니다.
- GCP Always Free 5GB와의 완벽한 궁합:
- GCP Cloud Storage는 모든 사용자에게 평생 매월 5GB의 무료 표준 스토리지를 제공합니다.
- 650MB의 Parquet 데이터는 5GB 한도의 13%에 불과하므로, 클라우드 스토리지 보관 비용은 영구적으로 $0.00입니다.
- 타입 안전성(Type Safety):
- CSV는 날짜나 부동소수점 숫자를 읽을 때마다 파싱 오버헤드가 발생하고 포맷 에러가 빈번합니다. Parquet은 바이너리 스키마가 파일 내부에 내장되어 있어 날짜(
DATE), 티커(VARCHAR), 주가(DOUBLE) 타입이 100% 무결하게 유지됩니다.
4. [엔진 결정] 왜 SQLite가 아닌 DuckDB인가? (AD-02)
많은 로컬 파일 기반 프로젝트들이 SQLite를 기본 엔진으로 채택합니다. 저 역시 초기에 SQLite를 검토했습니다.
하지만 백테스팅 쿼리를 날려보는 순간, 왜 SQLite가 대규모 시계열 분석에 부적합한지 절감했습니다.
📐 원본 Mermaid 도식 구조 접기/펼치기
flowchart TB
    subgraph SQLiteArch["행 기반(Row-Oriented) SQLite"]
        R1["한 행(Row) 전체를 메모리에 로드<br/>[Date, Ticker, Open, High, Low, Close, Volume, Shares...]"]
        R1 --> R2["종가(Close) 하나만 필요한데도 불필요한 컬럼 전부 디스크 I/O 발생"]
        R2 --> R3["CPU 단일 레지스터 순차 처리 (Slow)"]
    end

    subgraph DuckDBArch["컬럼 기반(Columnar) 벡터화 DuckDB"]
        C1["필요한 컬럼만 디스크에서 직독직해<br/>[Close 컬럼 벡터만 메모리 로드]"]
        C1 --> C2["SIMD CPU 명령어 기반 벡터화 연산 (Vectorized Execution)"]
        C2 --> C3["초당 수천만 행을 단 몇 밀리초 만에 연산 (Blazing Fast)"]
    end
- OLTP(트랜잭션) vs OLAP(분석):
- SQLite는 단건 삽입/수정(OLTP)에 최적화된 행 기반(Row-oriented) 엔진입니다. 1,000만 행에서 종가(
close) 하나를 계산하려고 해도 8개 컬럼 전체를 메모리로 퍼 올려야 합니다. - 반면 DuckDB는 대규모 집계와 필터링(OLAP)을 위해 탄생한 컬럼형(Columnar) 인메모리 OLAP 엔진입니다. 필요한 컬럼만 정확히 골라 읽으므로 I/O 낭비가 0에 수렴합니다.
- 프로세스 내장형(In-Process) 엔진의 무(0) 네트워크 오버헤드:
- DuckDB는 별도의 데이터베이스 데몬이나 서버를 띄울 필요가 없습니다. 파이썬 프로세스 메모리 안에 라이브러리로 직접 탑재됩니다.
- 따라서 네트워크 통신(TCP Socket), 직렬화/역직렬화(Pickle/JSON) 비용이 전혀 발생하지 않습니다.
- Parquet 직접 쿼리(Direct Parquet Scanning):
- DuckDB는 Parquet 파일을 별도의 테이블로 임포트(Import)하지 않고도, 디스크의 Parquet 파일을 마치 인메모리 테이블처럼 SQL로 직접 조회할 수 있습니다.
5. [동시성 결정] 단일 Writer와 다중 Reader 격리 (AD-03)
DuckDB의 유일한 약점은 여러 프로세스가 동시에 한 파일에 쓰기(Write) 작업을 수행할 때 파일 락(Lock) 충돌이 발생한다는 점입니다.
아키텍처 정의서(ARCH-QB-001)에서는 이를 해결하기 위해 CQRS(명령과 조회의 분리) 패턴을 단순화하여 적용했습니다.
📐 원본 Mermaid 도식 구조 접기/펼치기
flowchart LR
    subgraph Ingestion["데이터 수집 프로세스 (Writer)"]
        W1["신규 주가/재무 수집기"]
        W1 -->|"단일 Writer 배타적 락"| Store["📦 로컬 캐시 / GCS Parquet"]
    end

    subgraph Backtester["백테스트 시뮬레이션 (Readers)"]
        Store -->|"Read-Only 다중 연결"| E1["엔진 1 (QVM 팩터)"]
        Store -->|"Read-Only 다중 연결"| E2["엔진 2 (스윙 VCP)"]
        Store -->|"Read-Only 다중 연결"| E3["엔진 3 (매크로 ETF)"]
    end
- 데이터 수집기(Writer): 장 마감 후 하루 한 번만 동작하며, 새로운 날짜의 주가를 Parquet 파일에 추가(Append)할 때만 배타적 쓰기 락을 획득합니다.
- 백테스트 엔진(Reader): 백테스터는 Parquet 및 DuckDB 파일에
read_only=True플래그로만 접근합니다. 덕분에 여러 전략 시뮬레이션 프로세스가 동시에 수십 개의 코어에서 병렬로 돌아가도 락 충돌이나 데이터 오염이 100% 방지됩니다.
6. 정량 성과 대조표: 전통적 Cloud SQL vs GCS + DuckDB 레이크하우스
수직 추적성의 마지막 단계인 검증 시나리오(AV-01)에 따라, 35년 치 미국 전 종목 주가 데이터(4,400만 행)를 대상으로 실측 비교한 결과표입니다:
| 아키텍처 비교 항목 | 전통적 RDBMS (Cloud SQL db-f1-micro) | 우리 시스템 (GCS Parquet + DuckDB) | 개선 효과 및 아키텍처적 이점 |
|---|---|---|---|
| 월 고정 인프라 비용 | 최소 $30 ~ $50 / 월 | 월 $0.00 (GCP Always Free) | 영구적인 유지비 0원 달성 |
| 스토리지 용량 (35년) | 6.8 GB (CSV 원본 및 인덱스) | 650 MB (ZSTD 압축 Parquet) | 디스크 사용량 90.4% 절감 |
| 전 종목 모멘텀 집계 속도 | 평균 4.82초 (네트워크 RTT 포함) | 0.48초 (로컬 인메모리 벡터화) | 쿼리 속도 10배(1,000%) 향상 |
| 다중 프로세스 병렬 백테스트 | 동시 커넥션 풀 및 CPU 부하 급증 | Read-Only 무제한 멀티프로세싱 | 코어 수만큼 선형적 확장 가능 |
| 미래 데이터(Look-Ahead) 방어 | SQL 작성자 실수에 100% 의존 | PITDataPortal 클래스 강제 격리 |
엔지니어링 차원의 무결성 보장 |
7. 에필로그 & 다음 이야기: 이제 시점 고정 포털(PITDataPortal)을 만들 차례입니다
비용 0원에 4,400만 행을 0.5초 만에 스캔할 수 있는 강력한 데이터 레이크하우스가 완성되었습니다.
하지만 아무리 데이터가 빠르고 저렴해도, 백테스트 엔진이 ‘내일의 주가’나 ‘아직 공시되지 않은 분기 실적’을 훔쳐볼 수 있다면 그 결과는 100% 사기입니다.
사람의 집중력이나 주석문에 의존하는 것은 엔지니어링이 아닙니다. 코드가 미래 데이터를 호출하려 할 때 즉시 예외를 던지고 실행을 중단시키는 엄격한 시점 격리 장치가 필요합니다.
💡 다음 이야기 예고:
[Lap 2] [모듈 1: DataPortal] 미래 데이터를 보면 죽는 시점 포털
“왜 백테스트 코드는 내일의 데이터를 조회할 수 있는가?”
미래 참조 편향(Look-Ahead Bias)을 물리적으로 원천 차단하기 위해, 실패하는 선행 테스트(TDD RED)부터PITDataPortal클래스 구현(GREEN)까지의 모듈 개발기를 생생하게 전해드리겠습니다.